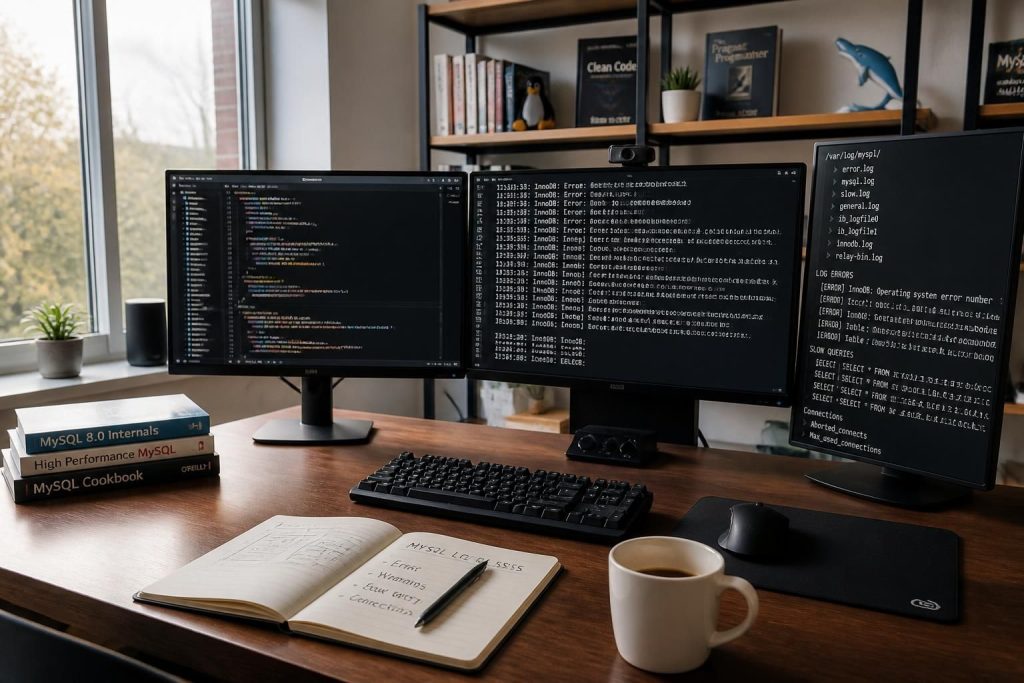
Quand une base MySQL ralentit, se bloque ou laisse passer une erreur discrète, le bon réflexe n’est pas de deviner. Les fichiers produits par mysqld racontent ce qui s’est vraiment passé, du démarrage du serveur aux requêtes les plus coûteuses. Bien les lire, c’est gagner du temps en dépannage MySQL, mieux piloter la performance base de données et garder la main sur la sécurité MySQL comme sur la journalisation MySQL.
L’article en bref
Les journaux MySQL ne servent pas seulement à corriger des pannes : ils aident aussi à comprendre l’activité du serveur, à suivre les requêtes sensibles et à préparer une réplication fiable.
- Lire le signal utile : identifier rapidement le bon fichier selon l’erreur observée
- Suivre l’activité serveur : relier connexions, requêtes et anomalies d’exécution
- Surveiller la performance : repérer les requêtes lentes et les index manquants
- Gérer les logs binaires : sécuriser la réplication et la rétention des traces
Une bonne analyse logs transforme un simple fichier texte en véritable tableau de bord de décision.
Dans une PME fictive comme Atlas Bureautique, une requête de recherche devient subitement lente après une mise à jour applicative. Le réflexe du développeur est de regarder le code ; celui de l’administrateur est d’ouvrir les journaux. C’est souvent là que se trouve la différence entre une base subie et une base maîtrisée.
Le mysqld log désigne en réalité plusieurs journaux complémentaires, chacun avec son rôle. Certains renseignent sur les erreurs MySQL, d’autres sur les connexions, les modifications de données ou les requêtes trop lentes. En pratique, cette gestion fichiers MySQL sert à éclairer le fonctionnement du serveur, à accélérer le diagnostic et à fiabiliser les opérations sensibles, notamment quand la réplication entre en jeu.
Comprendre les principaux fichiers de journalisation MySQL
MySQL ne se limite pas à un seul journal. Selon la configuration, le serveur peut écrire un log d’erreur, un log général, un log de requêtes lentes, un journal binaire et, dans les anciennes versions, un log de mise à jour devenu obsolète. Cette diversité n’est pas un détail technique : elle permet de cibler le bon niveau d’observation sans noyer l’équipe dans des traces inutiles.
Le point commun de ces fichiers est simple : ils racontent ce que fait mysqld. Le bon réflexe consiste donc à savoir quel journal consulter selon le symptôme, plutôt que d’ouvrir tout le répertoire de données au hasard.
| Journal | Ce qu’il enregistre | Usage principal |
|---|---|---|
| Log d’erreur | Démarrage, arrêt, alertes et incidents critiques | Dépannage MySQL et suivi des plantages |
| Log général | Connexions et requêtes exécutées | Traçabilité et monitoring MySQL |
| Slow log | Requêtes dépassant un seuil de temps | Optimisation requêtes et analyse de charge |
| Binary log | Modifications de données, ordre d’exécution | Réplication et restauration point-in-time |
Dans beaucoup d’environnements, ces fichiers se trouvent dans le répertoire de données, même si certains administrateurs préfèrent les déplacer vers un dossier dédié, comme /var/log/mysql/. Lorsqu’il faut forcer une rotation ou rouvrir un fichier, la commande FLUSH LOGS reste une habitude utile, surtout avant une sauvegarde ou un changement d’archive.
Cette logique de séparation est précieuse : elle évite de chercher une anomalie de performance dans un journal conçu pour les erreurs de démarrage. En matière de journalisation MySQL, la précision vaut toujours mieux que le volume.
Décrypter le log d’erreur pour le dépannage MySQL
Le log d’erreur est souvent le premier fichier à ouvrir lorsqu’un serveur refuse de démarrer ou s’arrête brutalement. Il rassemble les messages liés au lancement, à l’arrêt et aux incidents critiques, avec parfois des avertissements sur une table à vérifier ou à réparer. Sur certains systèmes, il peut même contenir une trace technique après un arrêt inattendu.
Un administrateur qui voit MySQL tomber sans explication cherchera rarement plus loin en premier lieu. C’est logique : ce journal donne souvent la chronologie exacte des derniers instants du serveur.
Dans un contexte concret, un arrêt non planifié peut laisser une ligne indiquant le redémarrage automatique, puis des informations sur l’état du serveur. Si une table demande une vérification, le log le signale généralement avant que l’utilisateur final ne remarque le problème. C’est précisément ce qui en fait un outil central de dépannage MySQL.
Pour aller vite, il est utile d’adopter une lecture par étapes :
- Repérer l’heure de l’incident pour recoller au contexte applicatif.
- Identifier le type de message : avertissement, erreur, arrêt normal, démarrage.
- Vérifier les tables concernées si un contrôle ou une réparation est suggéré.
- Comparer avec les autres journaux si le problème touche aussi les connexions ou les requêtes.
Cette méthode simple évite de confondre une panne serveur avec une lenteur applicative. Le log d’erreur n’explique pas tout, mais il donne presque toujours le point de départ le plus fiable.
Exploiter le log général et la journalisation MySQL pour suivre l’activité
Le log général consigne les connexions et les requêtes envoyées au serveur. Activé au démarrage avec l’option adaptée, il devient une source de contrôle utile pour comprendre ce qui circule réellement entre l’application et la base. Dans une phase de test ou lors d’un incident, il aide à vérifier si une requête a bien été transmise ou si un client se reconnecte en boucle.
Cette visibilité a un coût en volume, ce qui explique pourquoi beaucoup d’équipes ne l’activent que temporairement. Pour du monitoring MySQL, il sert surtout à confirmer une hypothèse, pas à rester allumé en permanence sur une production très sollicitée.
Dans un cas fréquent, une équipe pense qu’un problème vient d’une API. Le log général montre au contraire une avalanche de reconnections liées à un pool mal configuré. Ce simple constat suffit parfois à orienter le correctif.
Quand il faut le consulter, mieux vaut garder une méthode claire :
- définir la fenêtre horaire à inspecter ;
- croiser les connexions avec l’heure du symptôme ;
- vérifier l’origine applicative des requêtes ;
- limiter la durée d’activation pour éviter un journal trop volumineux.
En analyse logs, ce fichier sert de loupe sur l’activité normale. Il aide moins à diagnostiquer une panne qu’à reconstituer un scénario d’usage.
Repérer les requêtes lentes pour améliorer la performance base de données
Le slow log est l’allié naturel de l’optimisation requêtes. Il enregistre les commandes dont le temps d’exécution dépasse un seuil fixé par long_query_time, et peut aussi remonter les requêtes qui ne s’appuient pas sur des index lorsque l’option correspondante est activée. Pour une équipe qui veut améliorer la performance base de données, c’est souvent le journal le plus rentable à examiner.
Une requête lente n’est pas forcément mal écrite ; elle peut aussi révéler une table devenue trop volumineuse, un index manquant ou une jointure trop coûteuse. Le log ne juge pas, il met en lumière les points de friction.
MySQL propose aussi des outils de synthèse comme mysqldumpslow, utiles quand le journal devient trop dense. Plutôt que de lire ligne par ligne, il permet d’agréger les requêtes similaires et de repérer les motifs récurrents. Pour une équipe produit, ce type de lecture change vite la conversation : on ne parle plus d’un incident isolé, mais d’un vrai sujet d’architecture.
Les paramètres souvent associés au slow log méritent un regard simple :
| Paramètre | Rôle | Effet concret |
|---|---|---|
| slow_query_log | Active l’enregistrement des requêtes lentes | Permet de suivre les goulots d’étranglement |
| long_query_time | Définit le seuil de durée | Filtre les requêtes réellement problématiques |
| log_queries_not_using_indexes | Enregistre les requêtes sans index | Met en évidence un risque de lenteur |
Quand une boutique en ligne voit ses recherches catalogue ralentir, ce fichier donne souvent une piste directe. Et dans ce genre de dossier, quelques requêtes bien ciblées valent mieux qu’un long discours.
Maîtriser le binary log pour la réplication et la sécurité MySQL
Le journal binaire, souvent appelé binary log ou binlog, est aujourd’hui la pièce centrale pour la réplication MySQL et pour certaines restaurations avancées. Il enregistre les modifications apportées aux données dans un format plus efficace que l’ancien log de mise à jour, désormais dépassé. Pour les équipes qui s’intéressent à la continuité de service, c’est un fichier stratégique.
Sa valeur ne tient pas seulement à l’historique des écritures. Il conserve aussi l’ordre des opérations, ce qui permet de rejouer les changements avec précision après une sauvegarde ou un incident.
MySQL permet de sélectionner les bases concernées grâce à des options comme binlog-do-db ou binlog-ignore-db, même si leur usage demande de la rigueur pour éviter les effets de bord. Il faut également garder en tête que les tables transactionnelles et non transactionnelles ne sont pas gérées de la même manière dans le cache du journal.
Les fichiers binaires sont accompagnés d’un index qui recense les segments déjà créés. Côté exploitation, il est prudent de ne pas supprimer trop vite les anciens fichiers, surtout si la réplication est active. Une pratique courante consiste à faire tourner les journaux régulièrement puis à nettoyer avec discernement selon la politique de rétention.
Pour visualiser leur contenu, l’outil mysqlbinlog reste incontournable. Il permet de lire un binlog local, de le filtrer ou même d’en extraire le contenu vers un fichier texte, ce qui facilite les vérifications avant une opération sensible.
Exemple d’usage courant :
- Lire un fichier binlog pour vérifier une modification suspecte.
- Limiter la lecture à une base afin de réduire le bruit.
- Filtrer par date pour reconstituer une séquence précise.
- Exporter le résultat dans un fichier exploitable par l’équipe.
Dans le champ de la sécurité MySQL, ce journal joue un double rôle : il trace les modifications et soutient les plans de reprise. C’est une pièce discrète, mais difficile à remplacer quand tout doit être reconstruit proprement.
Organiser la gestion fichiers MySQL sans perdre le fil
Une bonne gestion fichiers MySQL repose moins sur des habitudes compliquées que sur une logique de classement cohérente. Les journaux gagnent à être stockés dans des emplacements lisibles, idéalement séparés des fichiers de données, avec une rotation régulière et des règles de conservation adaptées à l’activité.
Le point clé est simple : savoir quoi garder, combien de temps et pourquoi. Sans cela, les logs deviennent vite un empilement inutile, alors qu’ils devraient rester des preuves exploitables.
Une organisation claire aide aussi à sécuriser la maintenance. Par exemple, on peut réouvrir les logs avec FLUSH LOGS avant une rotation, ou archiver les fichiers générés après une période de suivi intensif. Cette discipline facilite les audits internes, les investigations et le monitoring MySQL au quotidien.
Voici une trame pratique pour garder des journaux utiles :
| Action | Pourquoi c’est utile | Moment conseillé |
|---|---|---|
| Centraliser les logs | Éviter de chercher dans plusieurs dossiers | Dès la mise en service |
| Faire tourner les fichiers | Limiter leur taille et garder l’historique lisible | Selon la charge et la politique interne |
| Archiver les segments utiles | Conserver une trace pour l’audit ou la reprise | Après un incident ou un cycle d’exploitation |
| Nettoyer avec prudence | Éviter de perdre une preuve indispensable | Quand la réplication et les sauvegardes sont vérifiées |
Une base bien tenue ne se résume pas à des requêtes rapides. Elle repose aussi sur une documentation vivante, des journaux lisibles et une équipe capable de relier un symptôme à sa cause.
Utiliser les logs comme levier de monitoring MySQL au quotidien
Les journaux MySQL deviennent vraiment puissants lorsqu’ils cessent d’être consultés seulement en cas de panne. Intégrés à une routine de monitoring MySQL, ils permettent de repérer les dérives avant qu’elles ne se transforment en incident visible pour les utilisateurs. C’est particulièrement vrai dans les environnements où la charge varie fortement au fil de la journée.
Une petite équipe e-commerce, par exemple, peut surveiller chaque matin les requêtes lentes de la veille, les erreurs récurrentes et l’activité du binlog si la réplication est en place. Ce rituel simple offre une vue concrète sur la santé de la base et évite les découvertes tardives.
Pour que ce suivi reste utile, il vaut mieux relier les logs à des questions précises : quelle requête a ralenti ? quel service a généré une vague de connexions ? quel changement a précédé l’erreur ? C’est là que l’analyse logs prend toute sa valeur, en rapprochant les faits techniques des décisions opérationnelles.
Une base MySQL bien observée n’est pas forcément une base complexe. C’est souvent une base dont les signaux ont été rangés au bon endroit, au bon format et au bon moment.
Quel log consulter en premier en cas d’erreur MySQL ?
Le log d’erreur reste le premier réflexe, car il indique souvent le démarrage, l’arrêt ou la cause probable d’un incident. Si le symptôme concerne aussi les requêtes ou la charge, il faut ensuite croiser avec les autres journaux.
Le slow log suffit-il pour optimiser une base ?
Il aide beaucoup, mais il ne remplace pas l’analyse du schéma, des index et des requêtes côté application. Le slow log sert surtout à repérer les points de friction et à prioriser les corrections.
Pourquoi le binary log est-il si important ?
Parce qu’il enregistre les modifications de données dans l’ordre exact d’exécution. Il est essentiel pour la réplication, certaines restaurations et le suivi des opérations sensibles.
Faut-il garder tous les journaux MySQL indéfiniment ?
Non, car ils peuvent devenir volumineux et difficiles à exploiter. Une politique de rétention claire, adaptée aux besoins de diagnostic, d’audit et de réplication, reste préférable.
Je suis Julien Marceau, rédacteur spécialisé en communication et marketing B2B. J’aide les dirigeants, indépendants et responsables com à y voir clair : de l’objet publicitaire à la campagne digitale, je décortique les méthodes qui marchent, sans jargon ni promesses en l’air. Mon truc : des guides concrets qu’on peut appliquer dès le lendemain.